

本文参考自《智能体 AI 漫游》
1.1 LLM工作原理
首先我们要明白LLM究竟是如何将文本读懂并且进行自然语言的回复的,这大致分成了四个阶段:分词(Tokenization)、嵌入(Embedding)、上下文处理(Context Processing)以及预测(prediction)。
我们来分别对这些名词进行简单的解释:
分词(Tokenization):使用学习得到的词表将原始文本切分为子词片段,但这个子词既不是字符也不是完整的单词。一个单词如”Luminous“有可能被分为”Lumi“和”nous“,也有可能被分为”Lu“和”minous“或者”Lumino“和”us“。这是分词器依据词表进行的机械切分,这一个个子词片段就是我们常说的”Token“。
嵌入(Embedding):每个根据词表切分出的 Token 都会从词表里对应的词那分到一个Token ID,而每个 Token ID 都会索引到一张学习得到的嵌入表中进行比对得到R^d(通常
d = 4096)中的稠密向量。这些向量代表的是这个词的语义,相似的词获取相似的向量。
上下文处理(Context Processing):Transformer 栈并行处理所有嵌入,然后通过自注意力机制让每个位置“读取”所有其他位置。经过 L 层之后,每个位置的隐藏状态编码了丰富的上下文信息。
预测(prediction):最终的隐藏状态被投影为整个词表上的概率分布,由解码策略选择下一个Token。
1.2 分词(Tokenization)
分词是将原始文本转换为语言模型所操作的离散符号的关键第一步。分词器的选择直接影响模型质量、多语种能力和计算效率。
1.2.1 为什么要将原始文本切分成子词使用?
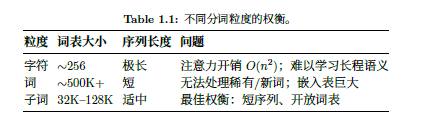
因为字符级模型需要很长的序列,如果有500个字符就需要500个位置,也就是序列长度=500,而Transformer的计算量=序列长度的平方,500个字也就是500的平方也就是25万次计算,十分费时费钱。可能有人会想到能不能用词级模型,想法很好,但是词级模型无法处理稀有词或者新词,所以也是行不通的。
所以,子词模型达到了二者的一个理想的平衡:常见词作为单个Token,稀有词被分为已知片段,比如“the”直接作为单个Token使用,而“cryptocurrency”被分为了“crypt”、”ocur“和”rency“,同时词表保持可控规模(32K-180K Token)。
这里有一张表格可以很直观地感受到它们之间地差距:
1.2.2 字节对编码(Byte-Pair Encoding,BPE)
字节对编码(BPE)是 GPT、Llama、Claude等大多数现代LLM采用的主流分词算法。
BPE算法:
BPE算法大致分四步
1.先从单个字符的词表开始。
给出一串字符:aaabdaaabac,每个字符相互之间独立无关,则初始词表为{a, b, d, c}。
2.统计训练语料中所有相邻符号对。
扫描整个语料,统计每个相邻字符组合出现多少次:
aa出现3次
ab出现2次
bd出现1次
da出现1次
ba出现1次
ac出现1次
3.将出现频率最高的对合并为一个新符号。
aa出现了3次,是出现次数最高的,那么aa就被合并为一个新词块,把它加入词表并把原文中所有的aa用这个新词块aa替换(后面将这个刺块成为Z)
所以,原文变为:Z a b d Z a b a c
4.重复步骤 2-3 共k次迭代,直到达到目标词表大小。
现在统计新语料 Z a b d Z a b a c 的相邻对频率:
Za出现2次
ab出现2次
bd,dZ,ba,ac各出现1次
假设最高频是 Za和 ab并列,我们随机先合并 Za 为 Y
原文变为:Y b d Y b a c
继续合并,Yb出现2次,合并为 X
原文变为:X d X a c
最终,词表从最初的{a,b,c,d}扩展成了{a,b,c,d, aa(Z), Za(Y), Yb(X)}。以后遇到新词,模型会优先使用最长的词块去套。
1.2.3 其它分词方法
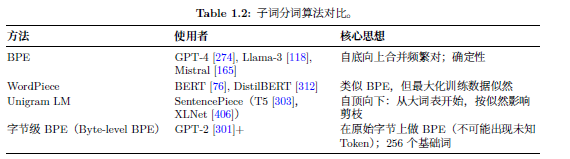
书上给出了一组直观的表格,因为BPE是目前最常用的分词算法,所以我们不对其他方法进行过多阐释:
1.2.4 分词最佳实践
1.词表的大小很重要。词表的最低限度是32K,128K 能提供更好的多语种覆盖和代码处理能力。Llama-3使用 128K Token。
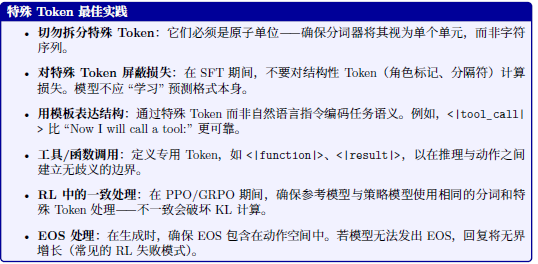
2.特殊Token:特殊Token包含在分词器的词表配置里,由“模板”在预处理时自动添加,如 bos表示这句话的开始,eos表示这句话的结束,pad表示填充,unk表示未知。指令微调模型需添加角色标记如|user|、|assistant|。
3.繁殖度:度量各语种每词的Token数。高繁殖度的,也就是每次产生很多Token的,表示对该语种的覆盖较差。
4.切勿跨边界分词:空格、标点和数字应该一致处理。大多数现代分词器会在前面添加空格标记如“read”会在前面加一个空格变为“ read”(注意,第二个read前面有一个空格),而reading一般会被切为“ read”和“ing”。
5.数字:对算术任务考虑数字级分词。“2026”切为“2”,“0”,“2”,“6”可以支持逐位推理。
6.代码:确保高效地分词空白(缩进)。Llama-3 将连续空格分词为单个Token。
- 附上分词的HuggingFace示例以及特殊Token的用途(摘自书籍《智能体 AI 漫游指南》):
1 | from transformers import AutoTokenizer |
特殊Token 是保留的词表条目,承载结构性含义而非语言内容。它们对控制模型行为至关重要。

指令微调模型的角色标记。现代对话模型使用特殊Token 来界定对话结构。它们并非被训练来承
载语义含义——而是结构分隔符,模型学习去解析它们:
1 | # Llama -3 对话模板 |
下期我们来分享Transformer架构,在学完Transformer后会让我们对嵌入等之后的部分有更深的理解。
说些什么吧!