

本文参考自《智能体 AI 漫游》
1.3 Transformer 架构
今天我们接着来分享AI界大名鼎鼎的Transformer架构,目的是为了能让大家弄明白为何这个设计如此天才,它背后的原理究竟是什么。相信今天大家看完这期内容,会对Transformer有个清晰的认识。
1.3.1 整体结构
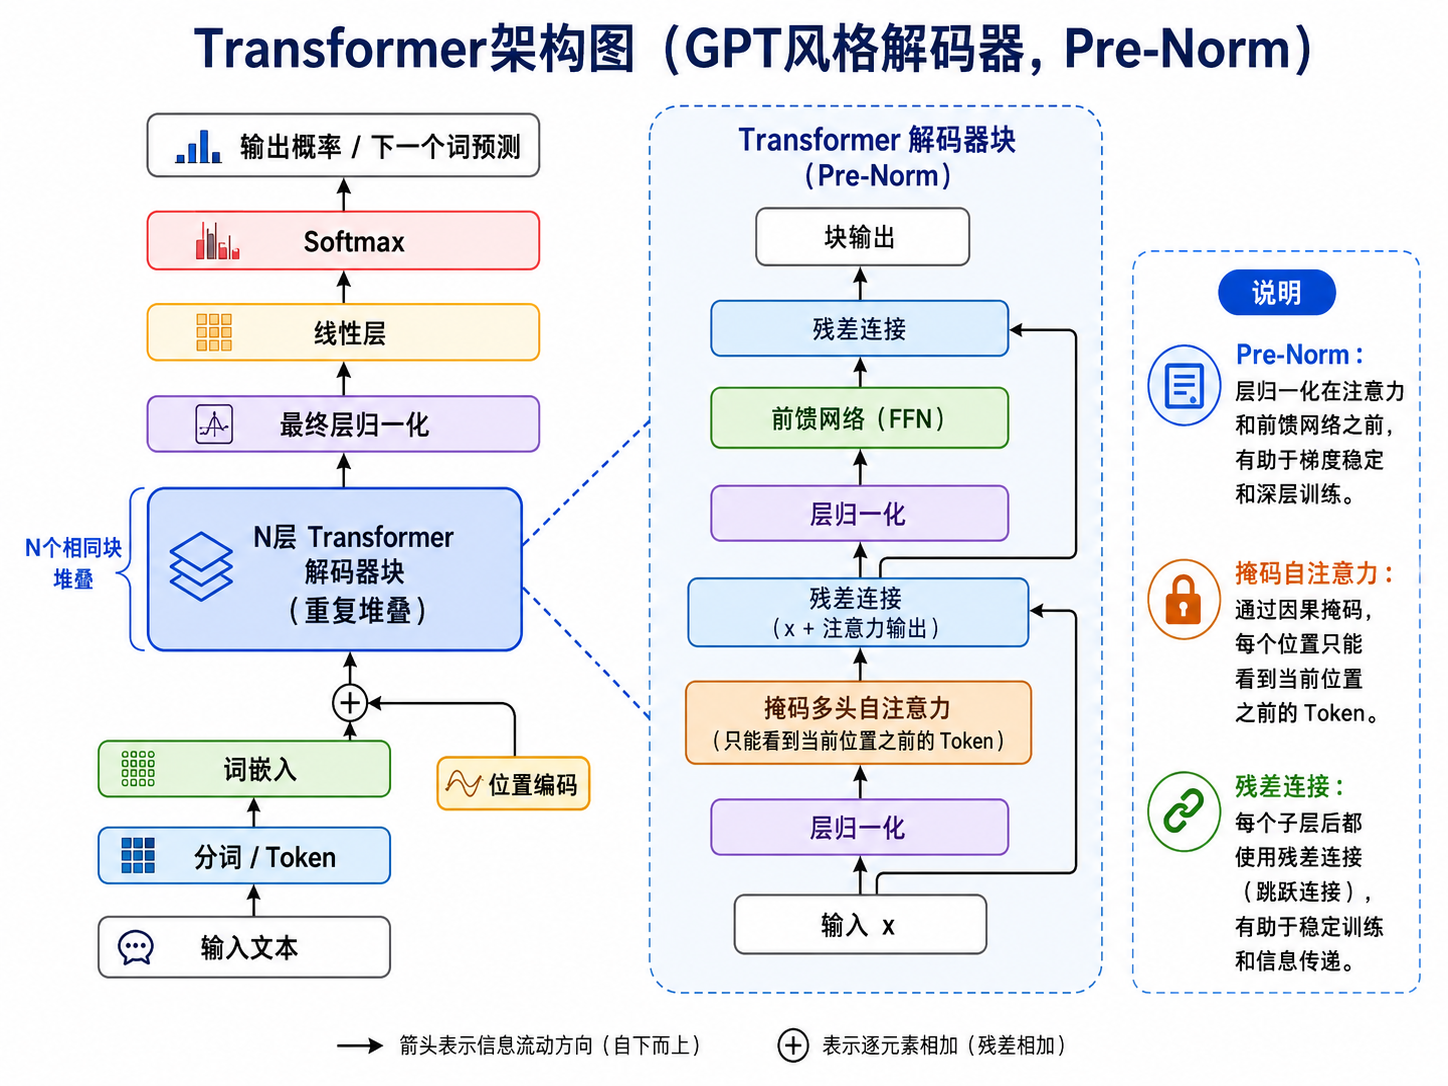
仅解码器(decoder-only)的 Transformer 依次通过嵌入层、重复的注意力+FFN 块以及最终对词表 logits 的投影来处理Token,下面这幅图展示了完整架构:
1.3.2 嵌入
在任何注意力或计算发生之前,Transformer 必须将离散的Token ID转换为神经网络可处理的连续向量。这就是嵌入层(Embedding Layer) 的作用。
在讲嵌入之前,我们先来讲讲 N-gram 模型。
N-gram模型
N-gram 是一种基于“统计计数”的语言模型,它是较早的一种语言模型。为什么说它是“统计计数”呢?因为它的工作原理就是统计在训练语料里字词组合出现的次数,出现的频率越高,在预测时出现这个组合的概率越大,而不会关注语义。所以它也就没有分词这一步。它这里的“N”代表一次性考虑连续 N 个词的长度,比如现在需要预测“我要看动”后面的接什么:
Unigram(1-gram):“动”只会考虑自己,不管上下文,预测“漫”的概率 = “动漫”这个词在语料中出现的概率。
Bigram(2-gram):依据“看动”在训练集与其他字的出现概率预测。
Trigram(3-gram):依据“要看动”进行预测。
以此类推。
而经过统计后发现“动漫”这个词在训练语料中总共出现6次,而“动物”这个词出现了4次(假设只有两种情况),那么在 1-gram 来看“动”后面接“漫”的概率为 6/(6+4)×100% = 60% ,接“物“的概率为4/(6+4)×100% = 40%;
而“看动漫”这个组合出现4次,“看动物”只出现2次,那么2-gram预测“看动”后面接“漫”的概率为 66.7%,接”物“的概率为 33.3%。
这样的工作原理使得N-gram的训练速度和推理速度都极快,训练只需要遍历语料库一次统计出字词组合出现的次数,而推理只需要把输入的最后 N-1 个词作为键去哈希表里把对应组合的概率取出来就行了。现在仍有许多特殊场景使用的模型需要用到N-gram。
但是N-gram的缺陷也十分明显:
- 数据稀疏:如果训练集里没有出现过“看动漫”这一组合,那么Trigram预测出“漫”这个字的概率就为0,只能使用大量数据集来覆盖这种情况,但是数据集不可能包含所有情况,这使得N-gram的预测十分死板。
- 无法处理长距离依赖:假如 N=5,模型在预测时会忽略第六个词之前的所有信息,这代表这个模型有着灾难级的上下文记忆,基本是说了下句忘这句。
- 维度爆炸:假设词表大小为10万,那么想统计5-gram,理论上可能有 10^25 种组合,内存根本存不下这么大的表。
- 语义真空:在N-gram眼里,“吃苹果”和“吃梨”完全是两个无关的概率条目,完全不知道它们都是可食用的水果。训练集里“吃苹果”有 100 次,“吃梨”有 0 次,那么它永远预测不出吃的是”梨“。
独热向量(One-Hot Vector)
后来人们就开始思考,能不能把这些字词转化成向量来表示,向量坐标相近的词含义也就越相近?这无疑是一个天才的想法。
最初,计算机用最简单的“独热向量(One-Hot Vector)”来表示词。假设词表里有10万个词,那一个词就是一个10万维的向量,且只有该词对应的那个位置是1,其余全是0(比如“苹果”是[0,…,1,…,0])。
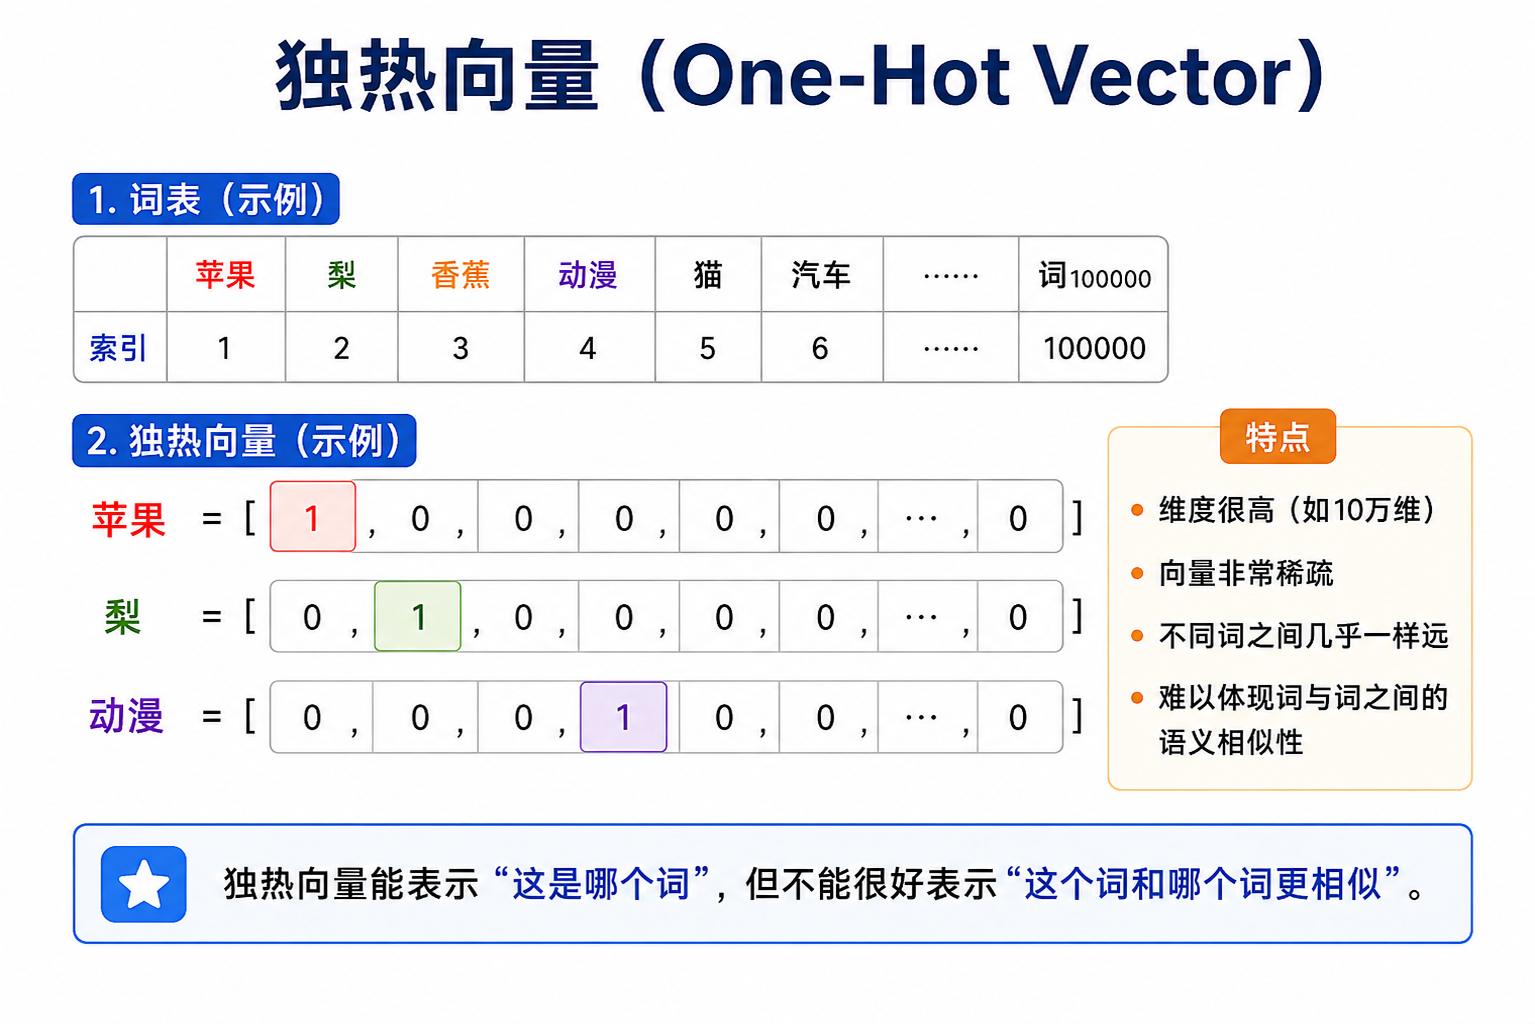
虽然这成功把文字变成了数字,但很快人们就发现了它的致命缺陷:“苹果”和“梨”的独热向量做点积,结果是0——在数学上它们毫无关系,模型完全看不出它们都是水果。而且,10万维的向量极其稀疏(大部分是0),根本算不动。
嵌入模型(Embedding)
后来,为了打破这种“语义真空”,我们引入了“嵌入(Embedding)”这一概念。嵌入是一个离散符号的学习得到的稠密向量的表示,我们要将词化作 R^d 中一个紧凑的向量,捕捉其含义。其中,R^d 表示“所有 d 维实数的向量”所构成的整个空间,d 一般在 50~12288维不等。
我们先来简化一下,假设这里有一个只有 x 轴和 y 轴的直角坐标系,横坐标为可食用度,纵坐标为自然实体度。你把“苹果”,“梨”和“动漫”这几个Token塞进这个坐标系内,那么“苹果”和“梨”因为都是可以吃的实实在在的水果,在坐标系内会挨得比较近,而“动漫”既不能吃也不是实物,所以它与其它二者距离就相对较远。距离的远近我们用向量的余弦相似度来表示,这样,我们就成功把 Token 之间的关系简单地用数字表示出来了。接下来模型就会根据这些向量之间的关系来进行判断,也就会认为“苹果”和“梨”是最相近的,属于同一类东西。
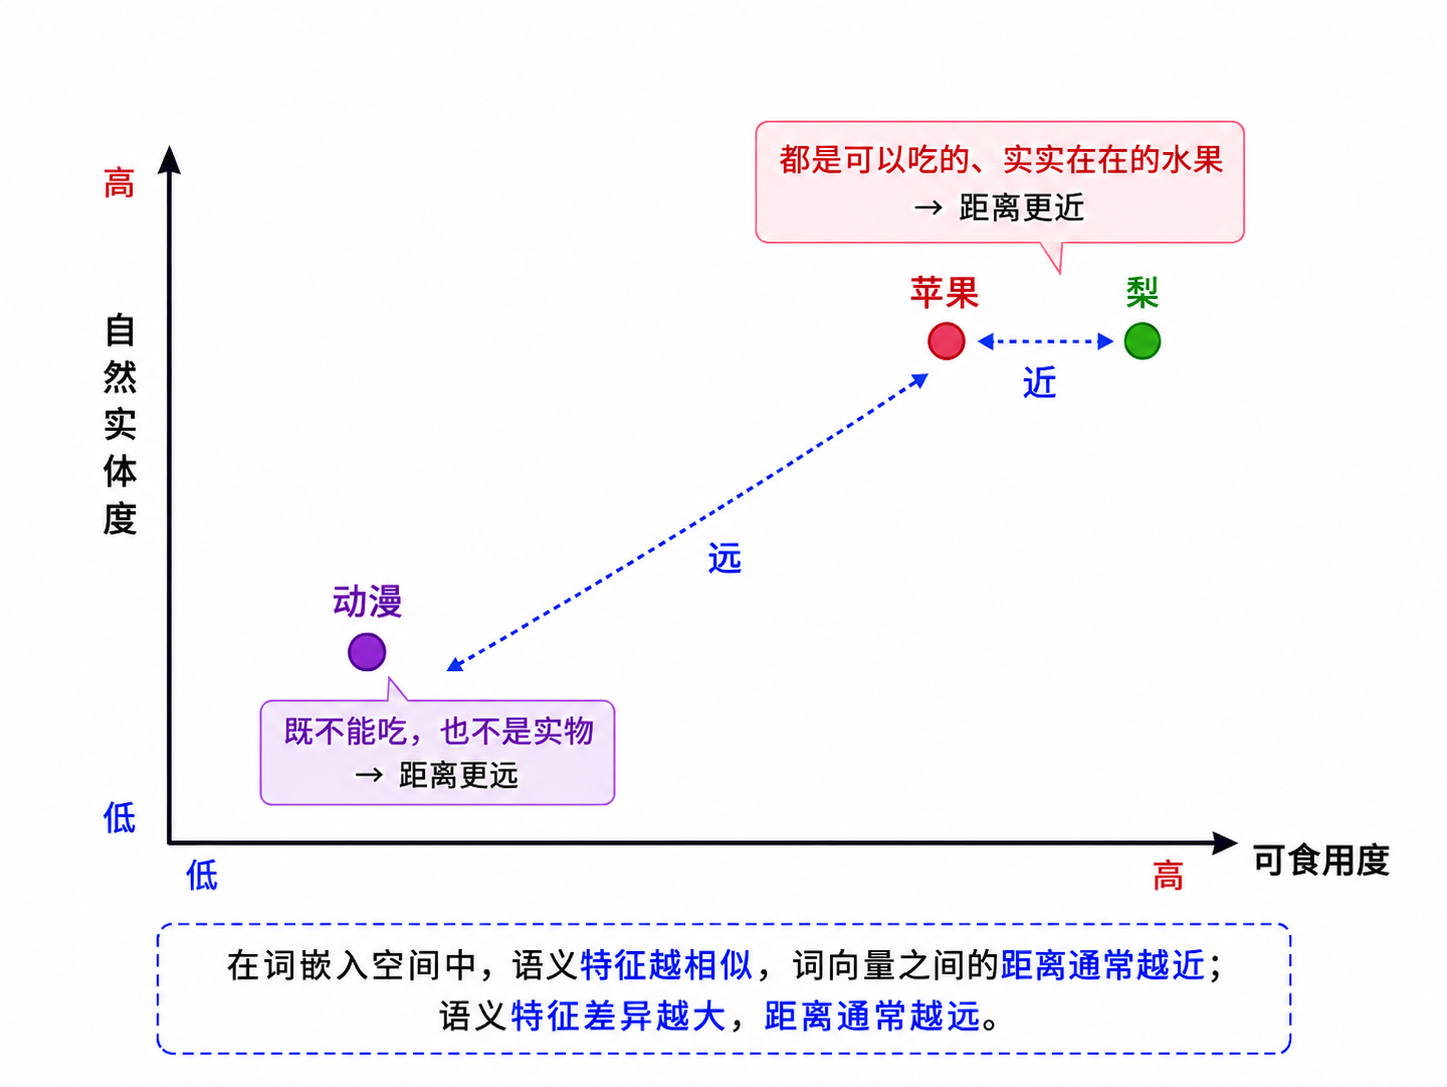
然而,真实情况是这个坐标系存在着成百上千个维度,这样才能全面地描述 Token 的每一个性质。词表中每个 Token 都有对应的一个ID,输入序列在经过分词后,每个 Token 都带上了词表赋予的ID,一个ID就是一个索引(Index),它们会并行地匹配嵌入表中对应的ID,匹配到了就给这个Token带上嵌入表中对应ID的向量数据,最后整句话的Token会组成一个向量矩阵X进行后续操作。
这里还牵扯到了一个各向异性(anisotropy) 问题,大体就是说词向量没有均匀地散布在整个高维空间中,而是全被“挤压”在了一个极其狭窄的锥形区域里,几乎所有向量都指向大致相同的方向。 最有效的解决方法就是 白化(Whitening),具体做法为模型训练完后,不修改模型参数,只把已经训练好的词向量拿出来,做一步数学变换(减去所有向量的均值,再除以协方差矩阵)。这里就不展开细讲,有兴趣的可以自己查阅相关资料。
1.3.3 自注意力机制
自注意力是核心操作,它允许每个Token 关注序列中其它每一个Token,基于相关性计算加权组合。
要搞懂自注意力机制。我们首先要搞懂缩放点积注意力(Scaled Dot-Product Attention)。
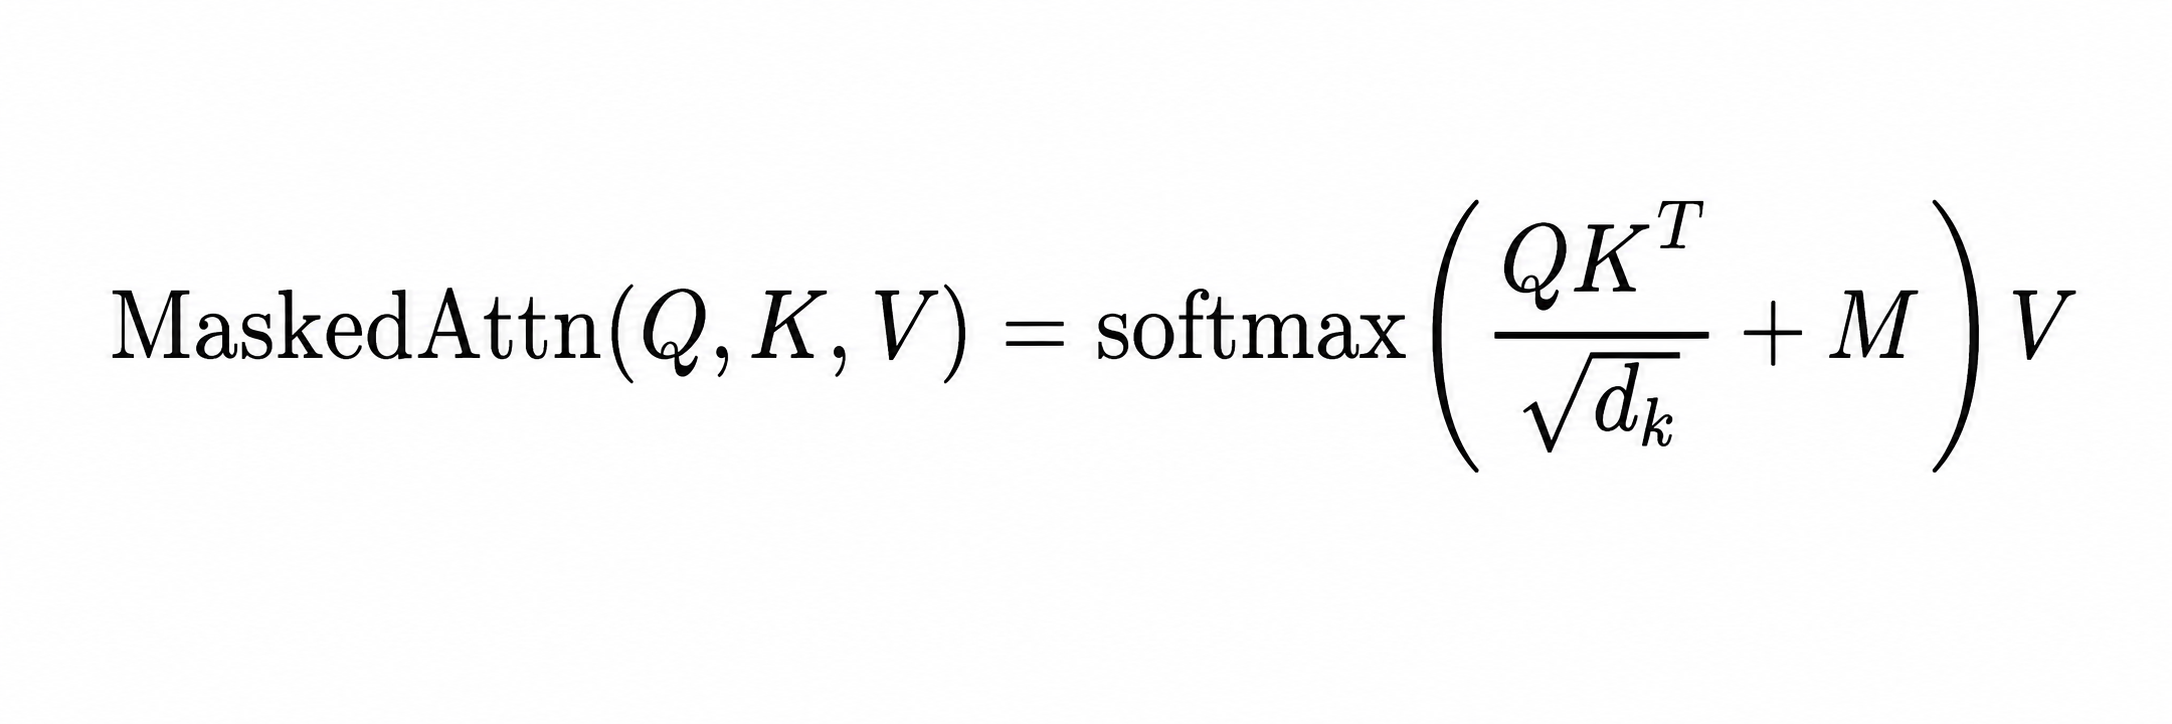
其中掩码 M 为:
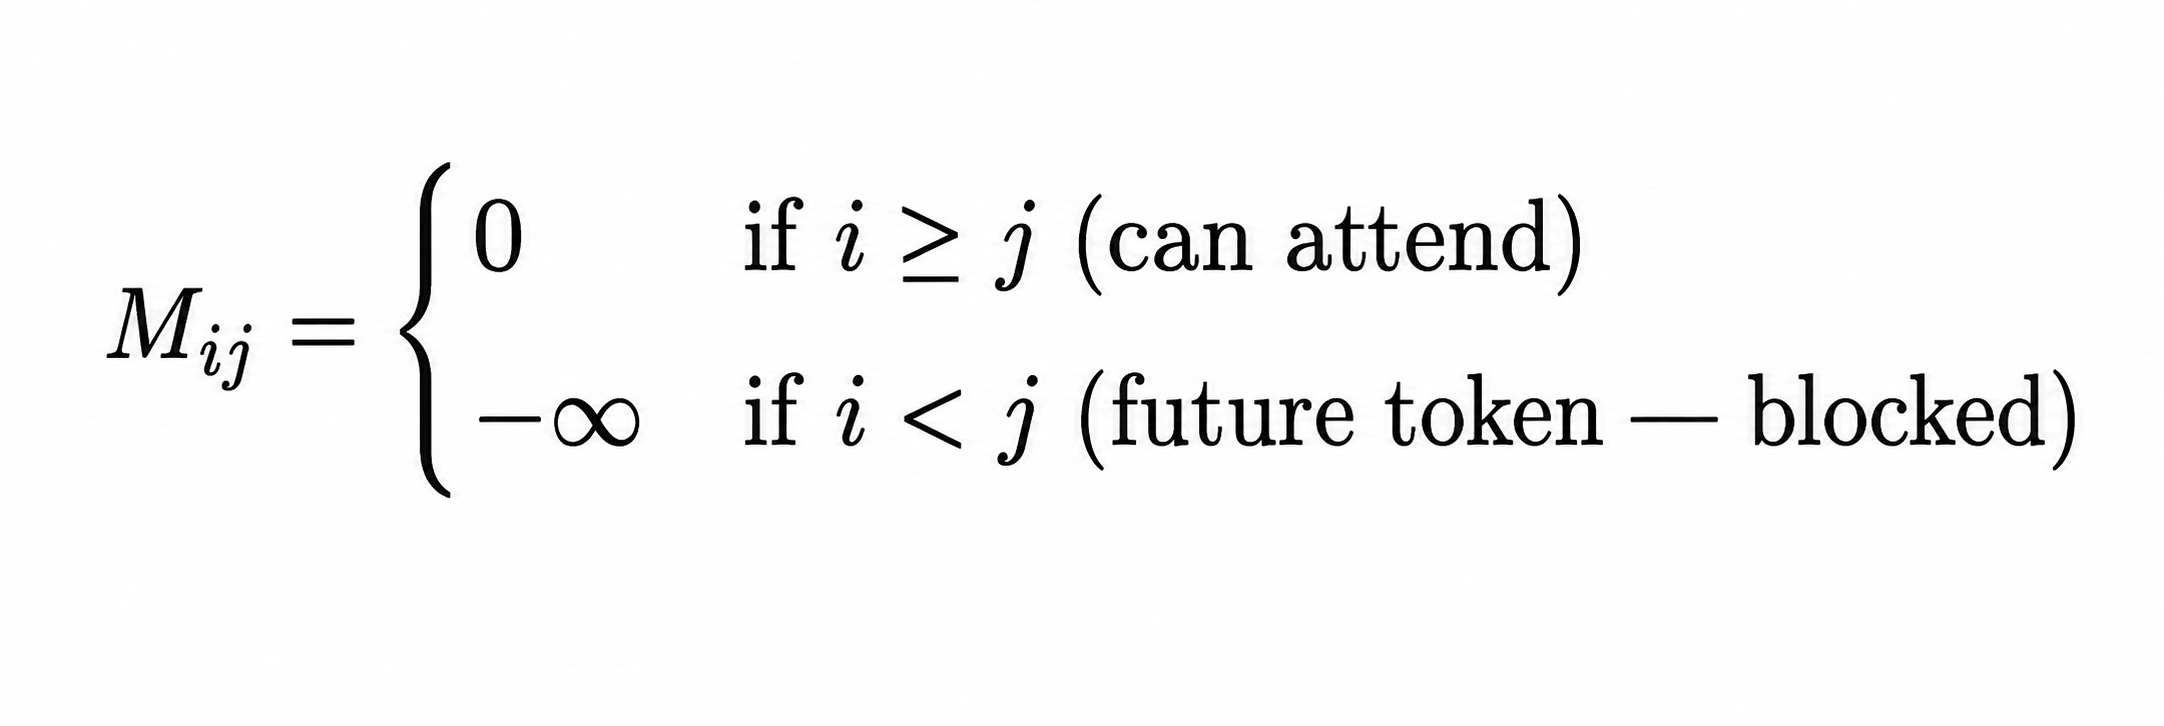
这是一个带掩码(Masked)的缩放点积注意力(Scaled Dot-Product Attention) 函数,是Transformer架构的核心机制。我们解释一下各符号的含义:
- Q(Query):查询矩阵,代表当前关注位置想要“问”的内容。
- K(Key):键矩阵,代表输入序列中每个位置的“索引标签”。
- V(Value):值矩阵,代表输入序列中每个位置实际的“内容信息”。
- d_k:Q 和 K 的维度(即每个头的特征数)。
- M:掩码矩阵(Mask Matrix)。
[!NOTE]
Q = X·W_Q,K = X·W_K,V = X·W_V,其中X为当前输入序列的嵌入矩阵,W为经过训练后的权重矩阵,或者叫线性投影层。
第一步:将查询矩阵Q与键矩阵K的转置矩阵点积(不转置无法相乘)。
PS:点积就是两组数组一对一相乘,再全部加起来。
把Q看作该位置Token的需求,K看作各Token的索引。当你输入一段序列时,这个序列中每一个Token的Q都会与该序列中其他Token的K做点积,因为点积是看两个向量的余弦相似度,点积的结果越大,说明它们越拟合,K越符合Q的预期。
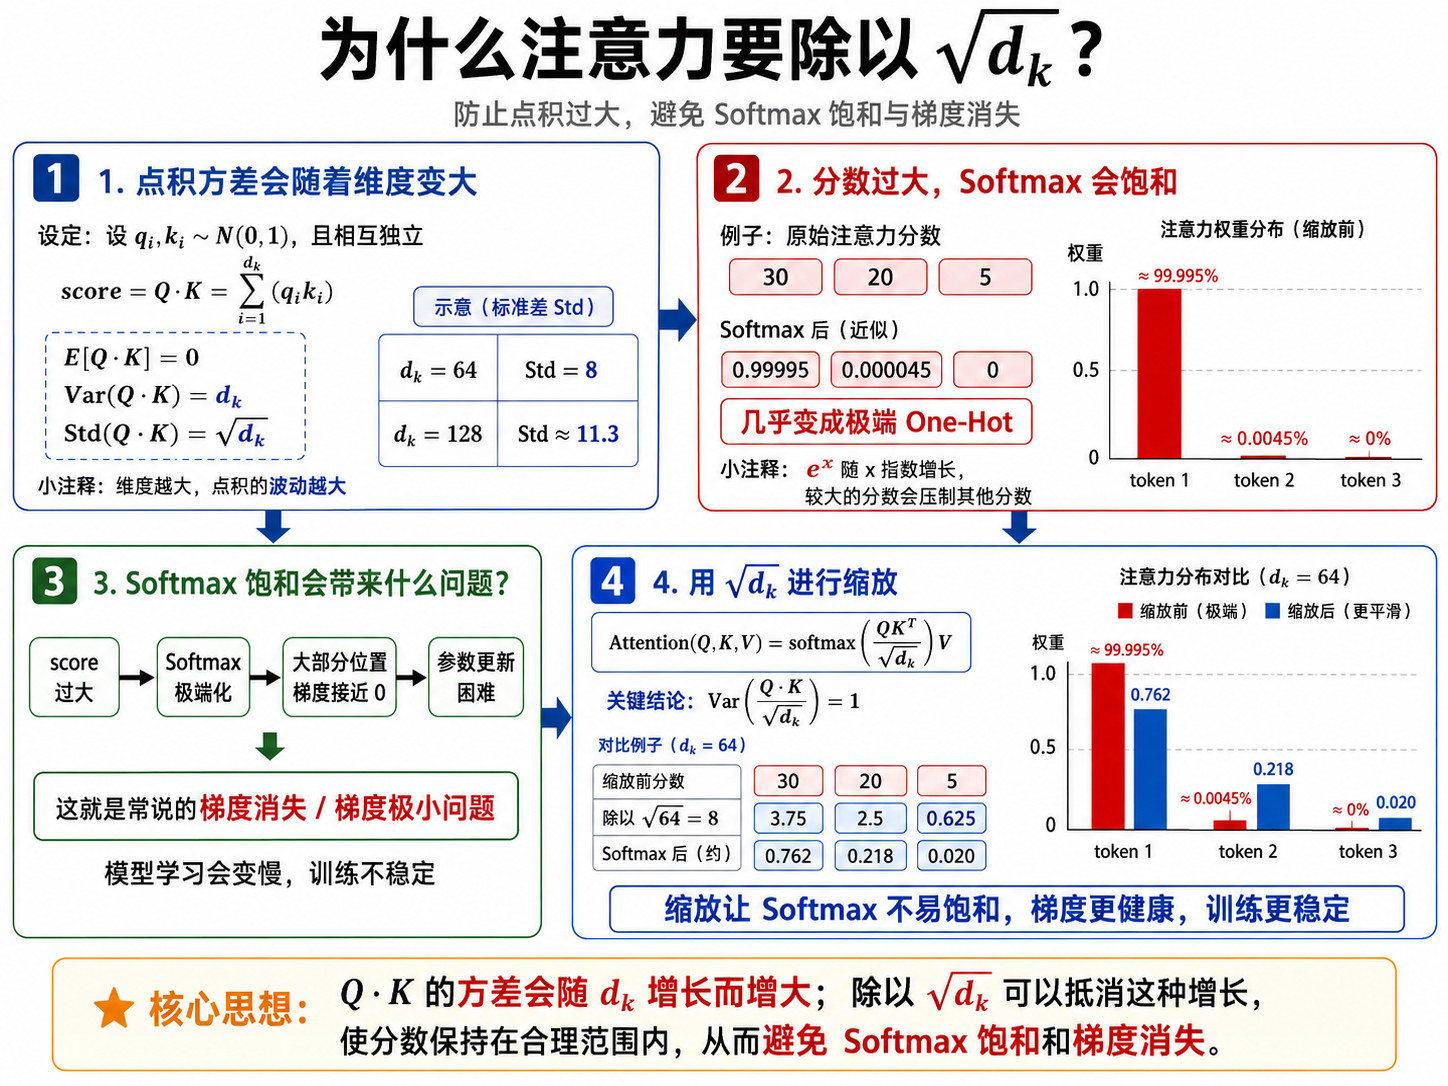
第二步:除以 根下d_k。
真实的大模型里,每个头的维度通常是64或128,假设Q和K里的每一个数字都服从标准正态分布,也就是均值为0,方差为1,当Q和K做点积后,方差就会暴增到 d_k,标准差就为 根下d_k,Softmax是计算 e^x 的,也就是说随着x增大,Softmax的计算结果是呈指数级增长的,如果x=30,e^30 就是一个天文数字,如果另一个得分为20,则 e^20 相比之下几乎可以忽略不计,得分30的那个Token的V权重就会变为100%,其它Token变为0,Softmax的输出会变成一种极端的 One-Hot,模型参数几乎无法更新。这就是著名的“梯度消失”。所以我们要除以维度标准差抵消掉标准差的增长。
第三步:加上因果编码。
那么什么是因果掩码?
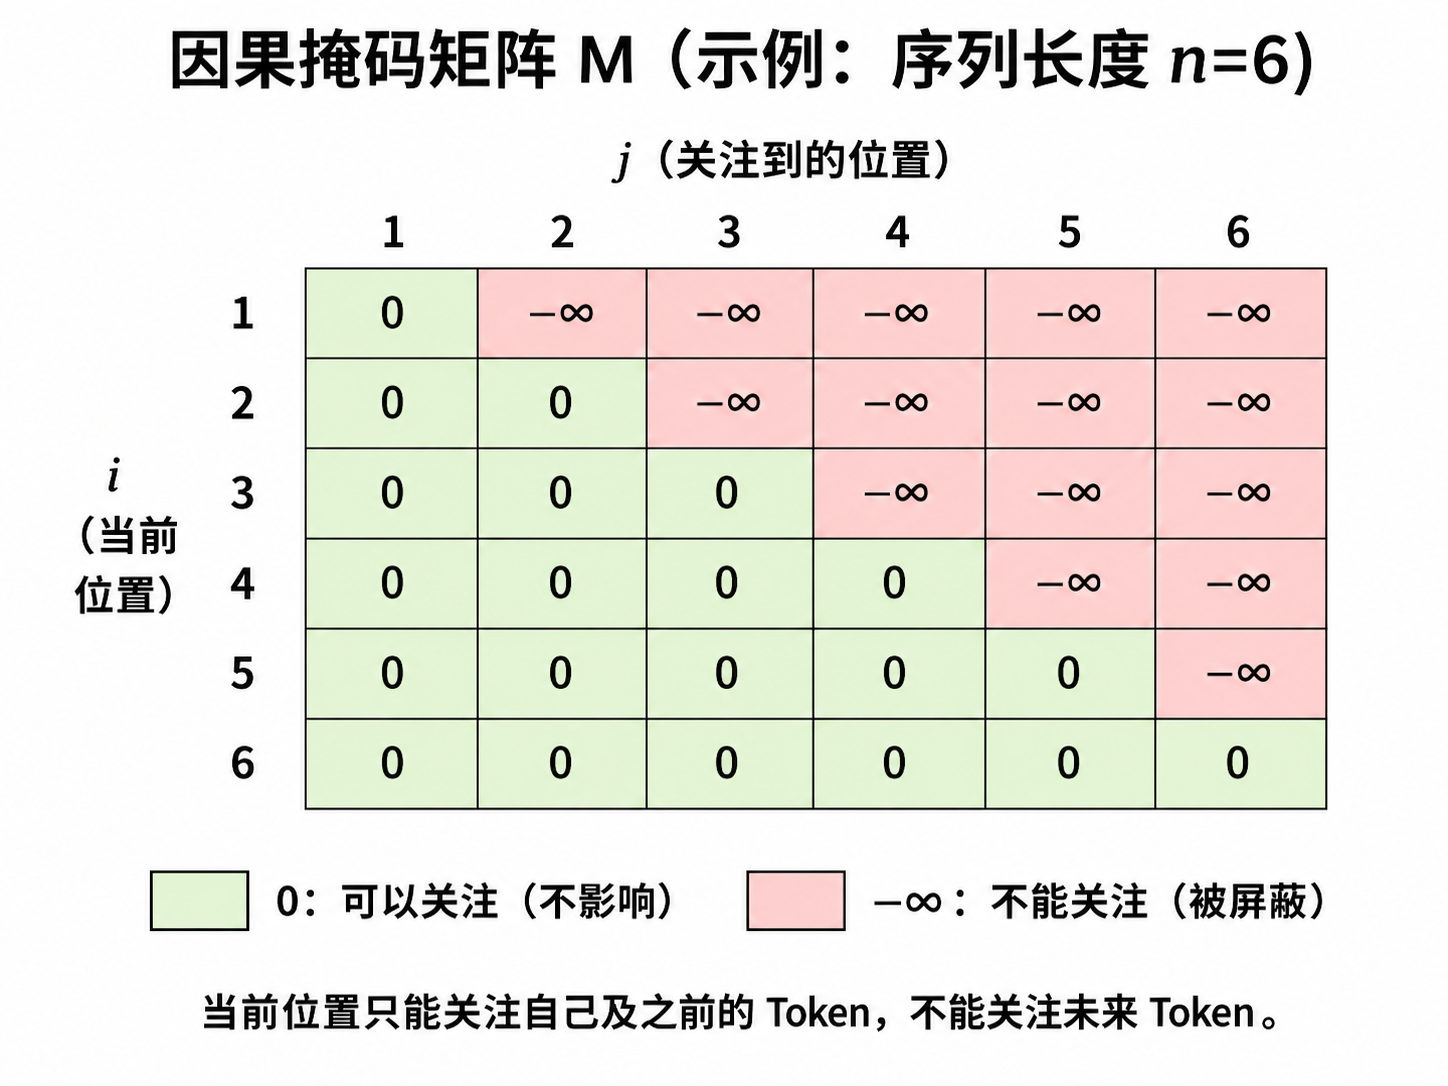
因果(Causal) 是一套链式法则,生成第 i 个 Token 的条件概率,仅依赖于前 i−1 个已知 Token,而严格独立于第 i+1 到第 n 个未来的 Token。首先我们来看上面这第二组函数,其中M被称作因果掩码(Causal Masking),或者叫**因果注意力(Causal Attention)**。
i 表示当前Token的位置,j 表示 i 当前关注到的Token的位置。正常我们读句子都是从左往右读,在读下一个字之前我们是不知道下一个字是什么的,只知道已经读过的字。落到上面的公式里面去,如果 i ≥ j,说明位置 i 的Token位于位置 j 的Token的右侧或者重合,那么位置 j 的Token就属于“已知Token”的范畴,那么M就为0;相反,如果 i <j ,说明位置 i 的Token位于位置 j 的Token的左侧,这个位置 j 的Token就属于“未来的,未知的Token”,这时M=-∞。将M带入到函数中去,当M为0时不影响当前Token的 V 权重,M为-∞时则当前Token的权重 V 无限接近于0,也就自动忽略这个V了。
第四步:计算Softmax。
Softmax是将一组杂乱无章的原始分数变成一组相加起来等于1的概率权重,并且让原本分数高的那个变得更高。这样一来,模型就能根据分数的高低,在后续‘加权求和’时,精准地决定该把绝大部分注意力倾注到谁身上。比如在计算‘吃’这个词时,即便‘苹果’的原始分数比‘自己’只高出一点点,经过 Softmax 的放大,‘苹果’也可能拿到超过 60% 的权重,从而让‘吃’的输出向量里充满‘苹果’的语义信息。
第五步:给V加权。
将注意力权重分别乘以矩阵V中对应的每一行,最后再将V的每一行向量相加,得到的向量就是该位置的上下文输出向量。
1.3.4 编码器-解码器 Transformer
Transformer一开始被提出是用于序列到序列的任务,比如机器翻译。那时主要使用的是编码器-解码器架构。虽然现在主流的LLM使用的是仅解码器变体(GPT风格),但是我们还是需要了解完整架构,因为交叉注意力和带掩码的自注意力都起源于此。作为基础模块,理解它们至关重要。
编码器(Encoder)
编码器双向地处理整个输入序列,每个 Token 都会同时关注序列中其他所有的Token(无因果编码)。也就是说,每一个Token都会同时并行地处理与其他Token的关系。这产生了丰富的上下文表征 ***H_{enc} ∈ R^{n×d}***,其中每个位置都编码了关于整个输入的信息:
- 输入:Token嵌入 + 正弦位置编码
- 每一层:多头自注意力 → Add & Norm → FFN → Add & Norm
- 无因果编码:位置 i 关注所有位置 1,…,n
- 输出:整个输入序列的上下文表征,也就是H_{enc}
解码器(Decoder)-带掩码的多头自注意力
解码器一次生成一个输出 Token (自回归地)。为了防止模型“看到未来”,解码器中的自注意力使用了因果掩码(causal mask)。
如果我们把翻译任务想象成“看一句英文,写一句中文”,那么编码器负责把整句英文读懂,解码器负责一个字一个字地写中文。它在写第一个字时,不能提前偷看第二个字;写第二个字时,只能看到第一个字和英文原文;写第三个字时,只能看到前两个字和英文原文。这样训练出来的模型,到了真正生成时才不会因为缺少“未来答案”而崩掉。
解码器内部通常有三块:
- Masked Multi-Head Self-Attention:只能看当前位置及之前的输出Token。
- Cross-Attention:拿解码器当前状态去查询编码器输出的***H_{enc}***,也就是“参考原文”。
- FFN:对每个位置的表示做进一步非线性加工。
这里的交叉注意力(Cross-Attention)很有意思。它的 Q 来自解码器,K 和 V 来自编码器输出。也就是说,解码器在生成中文时,会不断拿“我现在要写什么”这个问题,去编码器那里查“英文原文里哪些信息最相关”。这就像翻译时你眼睛看着原文,手上正在写译文,每写一个词都会回头确认一下原句里对应的信息。
所以,编码器-解码器架构适合文章翻译或者根据给定资料问答的场景,而像那种开放式/生成式问答,因为编码器起不上作用浪费算力而不被使用。
[!NOTE]
自注意力是“自己和自己对话”,Q、K、V 都来自同一个序列;交叉注意力是“译文去查原文”,Q 来自解码器,K 和 V 来自编码器。
1.3.5 仅解码器(Decoder-only) Transformer
现在的大语言模型,如 GPT、Llama、Qwen 等,主流使用的是仅解码器(Decoder-only) 架构。也就是说,它们没有单独的编码器,也没有传统机器翻译里的 Cross-Attention,而是把所有输入都放进同一个序列里,然后通过带因果掩码的自注意力从左到右生成。
举个例子,用户输入:“请解释Transformer”。模型并不是先用编码器完整理解问题,再用解码器回答,而是把这句话和对话模板一起变成一串Token,送进一层又一层的 Decoder Block。最后,模型根据最后一个位置的隐藏状态预测下一个Token。预测出一个Token后,再把它接回输入序列后面,继续预测下一个Token。如此循环,就形成了我们看到的一整段回答。
这也是为什么LLM看起来像是在“思考”,但底层其实是在不断做一件事:根据前面所有Token,预测下一个最合适的Token。
Decoder-only 架构之所以适合大语言模型,主要有三个原因:
- 训练目标简单:只需要做“下一个Token预测”,海量文本天然就能变成训练数据。
- 生成方式统一:写文章、写代码、翻译、总结,本质上都可以转化为续写。
- 扩展性强:参数量、数据量和算力增加后,模型能力会比较稳定地提升。
所以你会发现,大模型的“智能”不是从某一个神秘模块里突然冒出来的,而是从一个极其朴素的目标中涌现出来的:给定上下文,预测下一个Token。
1.3.6 多头注意力(Multi-Head Attention)
前面我们讲的是一个注意力头的计算过程。但真实的Transformer不会只用一个头,而是会使用多个注意力头并行计算,这就是多头注意力(Multi-Head Attention)。
为什么要多头?因为一句话里的关系不止一种。
比如“我把苹果放进冰箱,因为它快坏了”。这里的“它”指的是“苹果”,这是指代关系;“放进冰箱”又和“苹果”形成动作关系;“快坏了”则提供了原因关系。如果只有一个注意力头,模型就像只有一只眼睛,要同时盯住所有关系,很容易顾此失彼。而多头注意力就像给模型开了多组观察视角:有的头关注语法结构,有的头关注指代关系,有的头关注远距离依赖,有的头关注标点、换行、代码缩进等局部模式。
具体做法是:模型会把输入 X 分别乘以多组不同的权重矩阵,得到多组 Q、K、V。每一组 Q、K、V 都独立做一次缩放点积注意力,得到一个头的输出。最后把所有头的输出拼接起来,再通过一个线性层投影回原来的维度。
可以简单理解为:
1 | MultiHead(Q,K,V) = Concat(head_1, head_2, ..., head_h) · W_O |
其中每个 head 都是一次独立的 Attention 计算,W_O 是输出投影矩阵。多头注意力并没有改变“根据相关性加权求和”的本质,它只是让模型能够同时从多个角度理解同一段文本。
1.3.7 位置编码(Positional Encoding)
注意力机制有一个很反直觉的问题:它本身并不知道顺序。
对注意力来说,“我吃苹果”和“苹果吃我”如果只看Token集合,其实包含的是同几个词。但对人来说,这两句话意思完全不同,因为词的位置发生了变化。所以Transformer必须额外告诉模型:每个Token在序列里的位置是什么。
这就是位置编码(Positional Encoding) 的作用。它会给每个Token的嵌入向量加入位置信息,让模型既知道“这个Token是什么”,也知道“它排在第几个”。
最早的Transformer使用的是正弦位置编码(Sinusoidal Positional Encoding)。它用不同频率的 sin 和 cos 函数为每个位置生成一个固定向量。这样做的好处是模型不需要专门学习每个位置的参数,而且可以一定程度上泛化到训练时没见过的更长位置。
后来很多LLM使用了更适合长上下文的方式,比如旋转位置编码(RoPE,Rotary Position Embedding)。RoPE的核心思想是:不要简单地把“第几个位置”加到向量里,而是在Q和K做注意力计算之前,按照位置对向量做一次旋转。两个Token之间的相对距离不同,旋转后的角度关系也不同,模型就能通过这种方式感知“谁离谁更近,谁离谁更远”。
这也是长上下文模型很关注位置编码的原因。模型要读几十万Token甚至上百万Token时,如果位置感不稳定,就会出现“前文还在上下文窗口里,但模型像没看见一样”的问题。
1.3.8 前馈神经网络(Feed Forward Network,FFN)
注意力机制解决的是“Token之间怎么交换信息”的问题,但交换完信息之后,每个Token还需要对自己当前拿到的信息进行加工。这一步就是前馈神经网络(FFN)。
在Transformer里,FFN通常对每个位置独立运行。也就是说,第1个Token、第2个Token、第3个Token都会经过同一个FFN,但它们之间不会在FFN里互相看见。Token之间的信息交互已经在注意力层完成了,FFN负责的是把每个位置的表示变得更有表达能力。
标准FFN大致是:
1 | FFN(x) = Activation(x · W_1 + b_1) · W_2 + b_2 |
可以理解为先把向量从 d 维扩展到更高维,再经过激活函数筛选和扭曲,最后再压回 d 维。这个过程像是把一句话里每个Token的“临时理解”拿去做一次深加工:哪些语义要加强,哪些特征要抑制,哪些组合关系要变成更抽象的概念。
现代LLM里常见的FFN变体是 SwiGLU。它相比普通的 ReLU 或 GELU,多了一条“门控”路径。这个门控可以理解为一个开关,决定哪些信息应该被放大,哪些信息应该被拦下来。很多大模型使用SwiGLU,就是因为它在同等规模下通常能带来更好的表达能力。
1.3.9 残差连接与归一化
如果我们把Transformer堆得很深,比如几十层甚至上百层,就会遇到一个老问题:信息在层与层之间传递时容易变形,梯度在反向传播时也容易不稳定。于是Transformer引入了两个非常关键的设计:残差连接(Residual Connection) 和 层归一化(LayerNorm)。
残差连接的意思是:每个模块处理完之后,不是直接把结果交给下一层,而是把输入也加回去:
1 | 输出 = 模块输出 + 原始输入 |
这就像给信息开了一条直达通道。即使某一层暂时没有学到特别有用的变换,原始信息也不会被完全破坏,模型可以更稳定地堆得很深。
LayerNorm 则负责把每个Token的向量拉回一个比较稳定的数值范围。因为神经网络一层层计算时,数值可能越来越大或越来越偏,归一化就像是在每一层入口或出口处做一次“校准”,让训练过程不至于失控。
在原始Transformer里,常见结构是 Post-Norm,也就是先做子层计算和残差相加,再做Norm:
1 | x = LayerNorm(x + Sublayer(x)) |
但很多现代LLM更常用 Pre-Norm:
1 | x = x + Sublayer(LayerNorm(x)) |
Pre-Norm的好处是深层模型训练更稳定,梯度更容易往前传。你可以把它理解为:先把输入整理干净,再送进注意力或FFN里处理,处理完后再通过残差加回主干。
1.3.10 输出层与下一个Token预测
当输入序列经过一层又一层 Transformer Block 后,每个位置都会得到一个隐藏状态。对于 Decoder-only 模型来说,真正用来预测下一个Token的,通常是最后一个位置的隐藏状态。
这个隐藏状态会被送入一个线性层,投影到整个词表大小的维度。假设词表有10万个Token,那么输出就是一个10万维向量,其中每一个数字都代表一个Token的原始分数,这组分数被称为 logits。
接下来,模型会对 logits 做 Softmax,把它们变成概率分布。比如:
- “Transformer”的概率是 35%
- “架构”的概率是 20%
- “模型”的概率是 8%
- 其它Token分走剩下的概率
最后,解码策略会根据这些概率选出下一个Token。最简单的方式是贪心解码,也就是永远选概率最高的那个。但如果永远这样做,模型回答会很死板,所以真实应用里还会使用 temperature、top-k、top-p 等采样策略,让模型在“合理”和“多样”之间取得平衡。
不过无论采样方式怎么变,Transformer在底层做的事情始终没有变:把前面的Token变成上下文表示,再根据这个表示预测下一个Token。
1.3.11 小结
到这里,我们就可以把Transformer的工作流程串起来了:
- 原始文本先经过分词器,变成一串Token ID。
- Token ID 查嵌入表,变成连续的向量矩阵 X。
- 加入位置编码,让模型知道每个Token的顺序。
- 进入多层 Transformer Block。
- 每个Block里先通过自注意力让Token互相读取信息,再通过FFN加工每个位置的表示。
- 残差连接和LayerNorm保证深层网络可以稳定训练。
- 最后的隐藏状态被投影成词表上的 logits。
- 解码策略选出下一个Token,再把它接回序列继续生成。
所以Transformer真正厉害的地方,并不是某一个公式看起来多么复杂,而是它把几个设计组合得极其漂亮:嵌入负责表示语义,注意力负责建立关系,位置编码负责提供顺序,FFN负责加工信息,残差和归一化负责稳定训练,最后用一个统一的下一个Token预测目标把所有能力串起来。
这也是为什么Transformer会成为现代LLM的骨架。它没有把语言理解写成一堆人工规则,而是搭了一个足够通用、足够可扩展的学习机器。只要给它足够多的数据、算力和训练技巧,它就能从“预测下一个Token”这件看似简单的事里,学出翻译、写作、代码、推理以及对话这些复杂能力。
下期我们继续分享LLM架构中的优化部分,比如 KV Cache、MQA/GQA、RoPE扩展、量化、推理加速等内容,这些优化决定了大模型能不能从“理论上很强”变成“现实中跑得动”。
说些什么吧!